刚做完 TikTok MLE 的 OA,发现今年题型变了——以前都是纯 4 道 LC 风格题,这次变成 7 道选择题加 3 道机器学习算法实现题,格局完全不一样。选择题考的是 ML 基础和 CS 基础的结合,实现题按题面把核心步骤补全即可。整体难度不算高,稳过没问题,但得提前准备对方向——L1/L2 正则化、F1 Score 的手算、self-attention 的复杂度这些,进去前没想过是会考的东西。
前七题:选择题还原
七道选择题分两个方向——CS 基础和 ML 基础各占一半左右。我做的时候每题大概 1 到 2 分钟,留够时间给后面三道实现题。
Q1:TCP 和 UDP 的区别
题目问在以下哪个场景下应该选择 UDP 而不是 TCP——视频直播、文件下载、银行转账、邮件发送。
答案是视频直播。UDP 不保证顺序和可靠性,但延迟低,实时性要求高的场景(直播、在线游戏、语音通话)用 UDP 更合适;文件下载和金融交易对数据完整性要求高,必须用 TCP。
Q2:数据库索引
题目问 B 树索引和哈希索引的适用场景有什么区别,以下说法哪个正确——A. 哈希索引支持范围查询;B. B 树索引只适合等值查询;C. 哈希索引适合等值查询,B 树索引适合范围查询;D. 两者性能完全一样。
答案是 C。哈希索引对等值查询 O(1),但不支持范围查询(因为哈希之后顺序信息丢失了);B 树是有序结构,天然支持范围查询和排序。
Q3:进程和线程
题目问以下关于进程和线程的说法哪个正确——A. 进程共享同一块内存空间;B. 线程切换的开销比进程切换更大;C. 同一进程内的线程共享堆内存,但各自有独立的栈;D. 线程崩溃不会影响其所属的进程。
答案是 C。进程有独立的内存空间,进程内的线程共享堆(代码段、全局变量、文件句柄),但每个线程有自己的栈和寄存器状态。线程崩溃可能拖垮整个进程(比如空指针异常),所以 D 是错的。
Q4:L1 和 L2 正则化
题目问 L1 正则化和 L2 正则化的核心区别是什么——A. L1 产生稀疏权重,L2 使权重均匀缩小;B. L1 使权重均匀缩小,L2 产生稀疏权重;C. 两者都会产生稀疏权重;D. L2 正则化比 L1 更容易过拟合。
答案是 A。L1(绝对值惩罚)的梯度是常数,会把小权重直接推到 0,产生稀疏解,适合特征选择;L2(平方惩罚)的梯度和权重大小成正比,权重越大惩罚越强,最终使权重均匀缩小但不会变成精确的 0。
Q5:模型评估指标
题目给了一个二分类模型的混淆矩阵——TP=90,FP=10,FN=30,TN=70,问 F1 Score 是多少,选项是 A. 0.75,B. 0.818,C. 0.80,D. 0.857。
Precision = 90 / (90+10) = 0.9;Recall = 90 / (90+30) = 0.75;F1 = 2 × 0.9 × 0.75 / (0.9+0.75) = 1.35 / 1.65 ≈ 0.818。答案是 B。
这道题进去之前最好把 F1 的公式背熟,考场上现推容易算错。
Q6:梯度消失问题
题目问以下哪种方法不能缓解深度神经网络的梯度消失问题——A. 使用 ReLU 代替 Sigmoid 激活函数;B. 增加网络层数;C. 使用残差连接(ResNet);D. 使用 BatchNorm。
答案是 B。增加网络层数反而会加剧梯度消失,因为反向传播时梯度需要经过更多层的连乘,每层梯度小于 1 就会指数级衰减。ReLU 避免了 Sigmoid 的饱和区问题,残差连接提供了梯度的”高速公路”,BatchNorm 稳定了每层的输入分布,三者都是有效的缓解手段。
Q7:Self-attention 的计算复杂度
题目问 Transformer 中 Self-attention 的时间复杂度是多少,其中 n 是序列长度,d 是特征维度——A. O(n×d);B. O(n²×d);C. O(n×d²);D. O(n²+d)。
答案是 B。Self-attention 要对每对位置计算相似度(Q×Kᵀ),这一步是 O(n²×d)——n 个 query,每个和 n 个 key 做点积,每次点积是 O(d)。这也是为什么长序列 Transformer 的计算开销很大,各种高效 attention 变体(Linformer、FlashAttention)都在试图降低这个复杂度。
第 8 题:最长连续相同字符子串
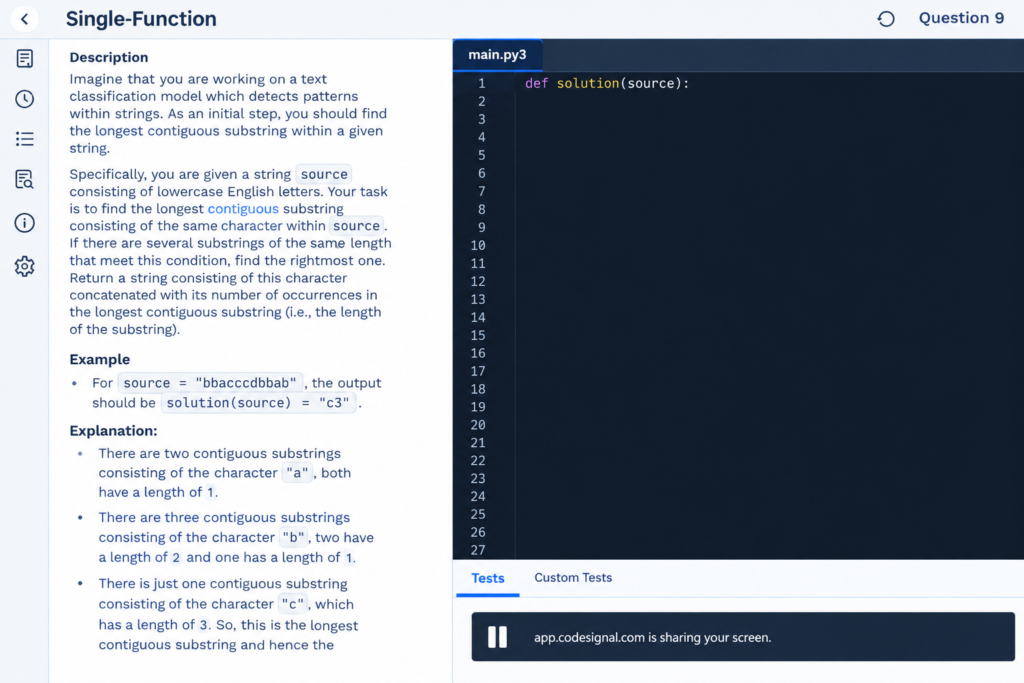
题意
给定小写字符串 source,找由同一字符构成的最长连续子串;若有多段长度相同,取最靠右的那段。返回该字符加长度,例如 “c3″。
示例:bbacccdbbab → 最长是连续 3 个 c,输出 “c3″。
思路
在字符串末尾加一个哨兵(如 #),一次遍历收尾:维护当前连续段长度,以及全局最长答案(字符加长度)。当 s[i] != s[i-1] 时,用刚结束的那段更新答案——长度优先,同长度取更靠右的(所以用 >=)。哨兵保证最后一段也会被结算。
def longest_consecutive(source):
    s = source + '#'
    best_char, best_len = s[0], 0
    cur_len = 1
    for i in range(1, len(s)):
        if s[i] == s[i-1]:
            cur_len += 1
        else:
            if cur_len >= best_len:  # >= 保证同长取最右
                best_len = cur_len
                best_char = s[i-1]
            cur_len = 1
    return f"{best_char}{best_len}"
O(n) 扫完,注意同长度取最靠右的用 >= 而不是 >。
第 9 题:线性模型 / 梯度更新
题意
补全线性回归的训练代码:根据均方误差(MSE)算梯度,不断调整权重和偏置,使预测逐渐接近真实值。
思路
线性回归梯度下降的四步——前向、损失、反传、更新:
def train_step(X, y, w, b, lr):
    n = len(y)
    # 前向
    y_pred = X @ w + b
    # 损失(MSE)
    loss = np.mean((y_pred - y) ** 2)
    # 反传(MSE 对 w、b 的梯度)
    error = y_pred - y
    dw = (2 / n) * X.T @ error
    db = (2 / n) * np.sum(error)
    # 更新
    w -= lr * dw
    b -= lr * db
    return w, b, loss
注意样本维度:X 是 (n, d),y 是 (n,),w 是 (d,),矩阵乘法方向别写反。MSE 的梯度系数是 2/n,有些题面写的是 1/n(用 MAE 或不带 2 的 MSE),按题面给的公式来。
第 10 题:决策树(熵、信息增益、预测)
题意
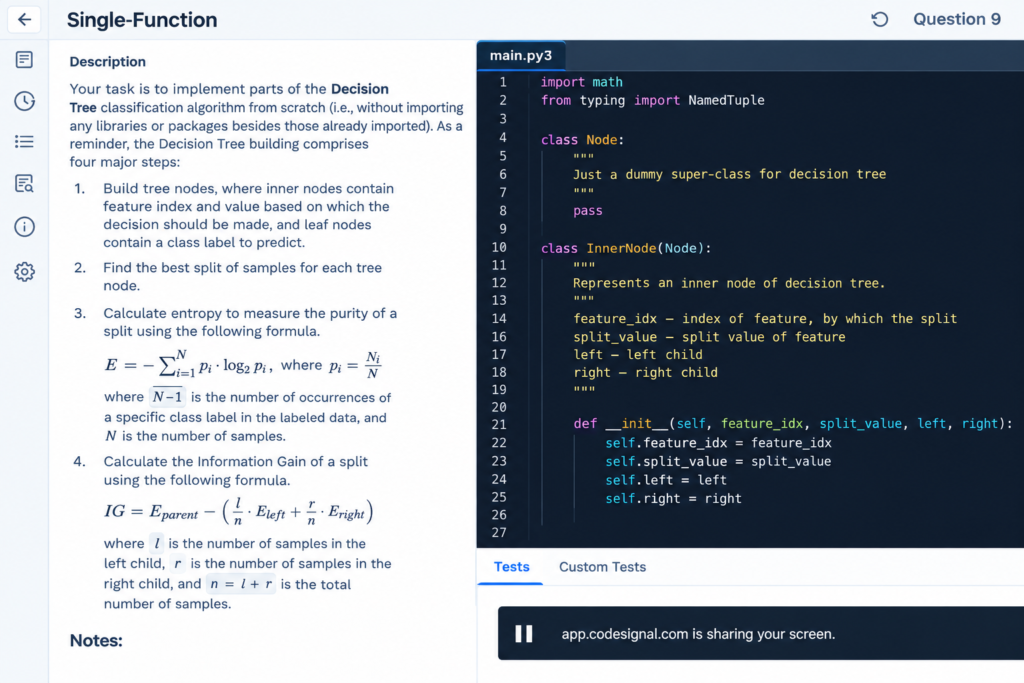
从零实现决策树分类的关键部分(不额外导包):用熵衡量节点纯度,用信息增益选最佳划分,预测时按特征值走左/右子树。
公式:
熵:E = -Σ pᵢ log₂ pᵢ
信息增益:IG = E_parent – (l/n × E_left + r/n × E_right)
思路
import math
from collections import Counter

def entropy(labels):
    n = len(labels)
    if n == 0:
        return 0
    counts = Counter(labels)
    return -sum((c/n) * math.log2(c/n) for c in counts.values() if c > 0)

def best_split(X, y):
    parent_entropy = entropy(y)
    best_ig, best_feat, best_val = -1, None, None
    n = len(y)
    for feat_idx in range(len(X[0])):
        thresholds = set(row[feat_idx] for row in X)
        for val in thresholds:
            left_y = [y[i] for i in range(n) if X[i][feat_idx] <= val]
            right_y = [y[i] for i in range(n) if X[i][feat_idx] > val]
            if not left_y or not right_y:
                continue
            ig = parent_entropy - (
                len(left_y)/n * entropy(left_y) +
                len(right_y)/n * entropy(right_y)
            )
            if ig > best_ig:
                best_ig, best_feat, best_val = ig, feat_idx, val
    return best_feat, best_val

def predict_one(node, x):
    # node 是 InnerNode 或叶子,按题面结构走
    while hasattr(node, 'feature_idx'):
        if x[node.feature_idx] <= node.split_value:
            node = node.left
        else:
            node = node.right
    return node.label  # 叶子节点返回类别
题面已给出 InnerNode 和叶子节点的结构,按步骤补全 fit / predict 即可。注意熵计算时 p = 0 的项要跳过(log₂0 是负无穷)。
补充:Bagging 实现题
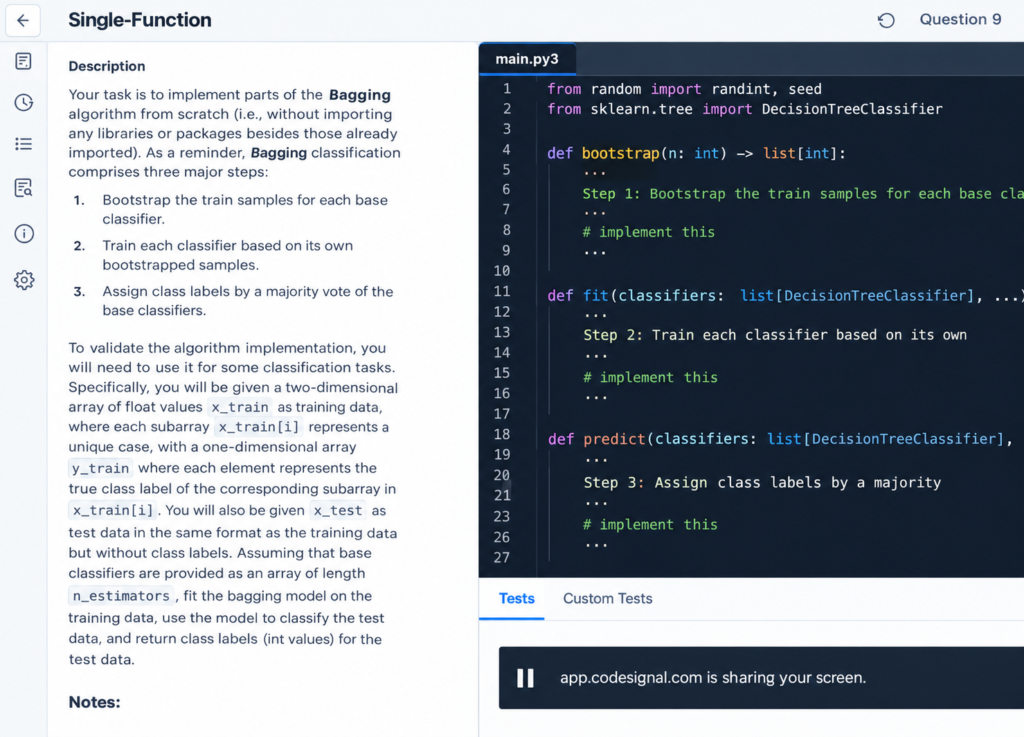
部分场次会额外出现 Bagging 补全题:
import numpy as np
from sklearn.tree import DecisionTreeClassifier
from collections import Counter

class BaggingClassifier:
    def __init__(self, n_estimators=10, random_state=42):
        self.n_estimators = n_estimators
        self.random_state = random_state
        self.estimators = []

    def fit(self, X, y):
        rng = np.random.RandomState(self.random_state)
        n = len(y)
        for _ in range(self.n_estimators):
            # Bootstrap:有放回抽样
            indices = rng.choice(n, size=n, replace=True)
            X_boot, y_boot = X[indices], y[indices]
            clf = DecisionTreeClassifier()
            clf.fit(X_boot, y_boot)
            self.estimators.append(clf)

    def predict(self, X):
        # 各基分类器投票,取多数类
        all_preds = np.array([clf.predict(X) for clf in self.estimators])
        result = []
        for col in all_preds.T:
            result.append(Counter(col).most_common(1)[0][0])
        return np.array(result)
注意随机种子要在 fit 里统一管理,平票规则按题面处理(most_common 默认取第一个)。
几点体会
这场最大的变化是选择题里 Transformer 相关内容的比重明显增加——self-attention 的计算方式、多头注意力的作用、位置编码的意义都出现过,和 TikTok 这两年在 LLM 推荐系统上的投入方向一致。
三道实现题的核心是”能不能按定义把经典算法写对”,不是刷 LC Hard。把熵的公式、MSE 梯度、Bootstrap 采样这几个模板提前写熟,进去主要是读题和对接口,时间完全够用。
有在准备 TikTok MLE 或其他大厂 MLE 岗的同学,可以来找我们聊聊。InterviewShow 整理了 TikTok、字节跳动、Google 这些公司的 MLE 面试题型,决策树、梯度下降、Transformer 基础这几块都有专门覆盖,有需要的来聊。