刚做完 DRW Intern OA ,整体感受:题量不大,但每道都挺吃思维。时间大约 2 小时,压力有点紧,需要快速建模。
进去之前以为 DRW 会出一堆量化概率题,结果两道都是纯算法,一道字符串贪心,一道树形 DFS。但和普通算法 OA 不一样的地方是:条件设计得很精巧,随便套模板会卡在边界上。
Task 1:偶数次出现的最大整数
题意
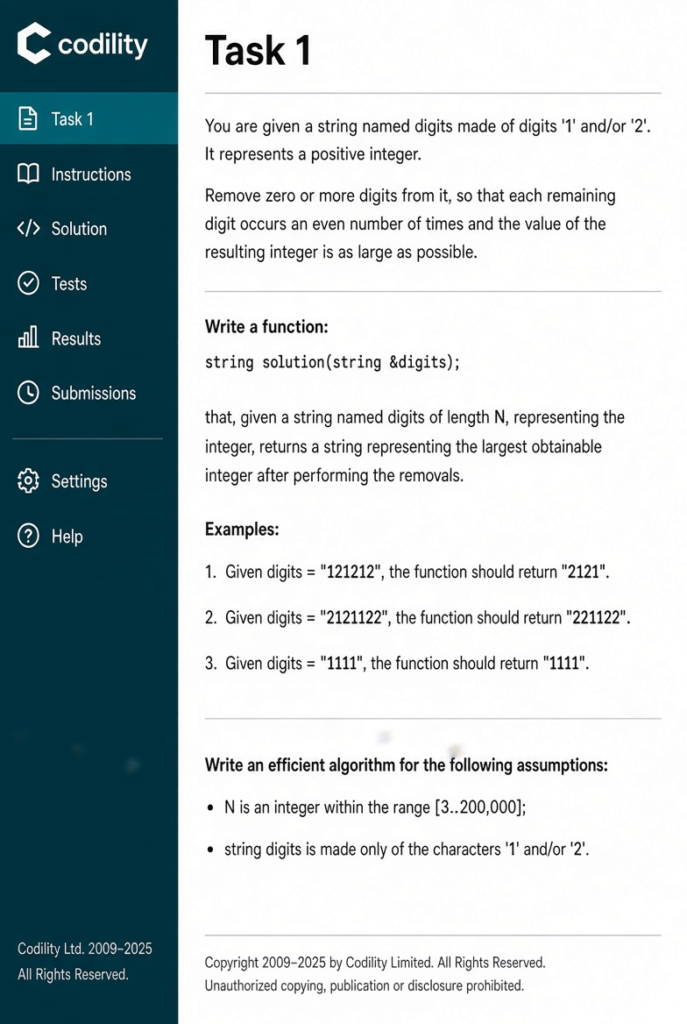
给定只由字符 ‘1’ 和 ‘2’ 组成的字符串 digits,表示一个正整数。可以删掉任意个数字,使得剩下的每个数字出现次数都是偶数,且得到的整数尽可能大。返回这个最大整数对应的字符串。
示例:”121212″ → “2121”;”2121122″ → “221122”;”1111″ → “1111”。
约束:长度 N ∈ [3, 200000],只含 ‘1’、’2’。
思路
只有两种字符,先统计 ‘1’ 和 ‘2’ 各自的个数。
若某个数字出现奇数次,必须删掉至少 1 个才能变成偶数次。关键问题是删哪个——为了让结果最大,应该删掉靠后的、对高位影响最小的那一个。
贪心写法:从左到右构造结果,同时统计已选数量的奇偶。若最终某个数字仍是奇数次,从结果里删掉最后一个该数字(对数值影响最小)。本题只有 ‘1’ 和 ‘2’,不会出现前导零问题。
def max_even_integer(digits):
    count = {'1': 0, '2': 0}
    for c in digits:
        count[c] += 1

    to_remove = {c: count[c] % 2 for c in count}

    result = list(digits)
    for c in ['1', '2']:  # 先删小的,尽量保留大的
        if to_remove[c]:
            for i in range(len(result) - 1, -1, -1):
                if result[i] == c:
                    result.pop(i)
                    break

    return ''.join(result) if result else ""
边界要注意:两种字符都需要删时,优先处理 ‘1’,保住高位的 ‘2’;删完为空时按题意处理(N≥3 且只有 1/2,基本不会出现,但代码要防御)。
整体 O(N),一次统计加一次扫描构造。
Task 2:统计平衡节点(多叉树)
题意
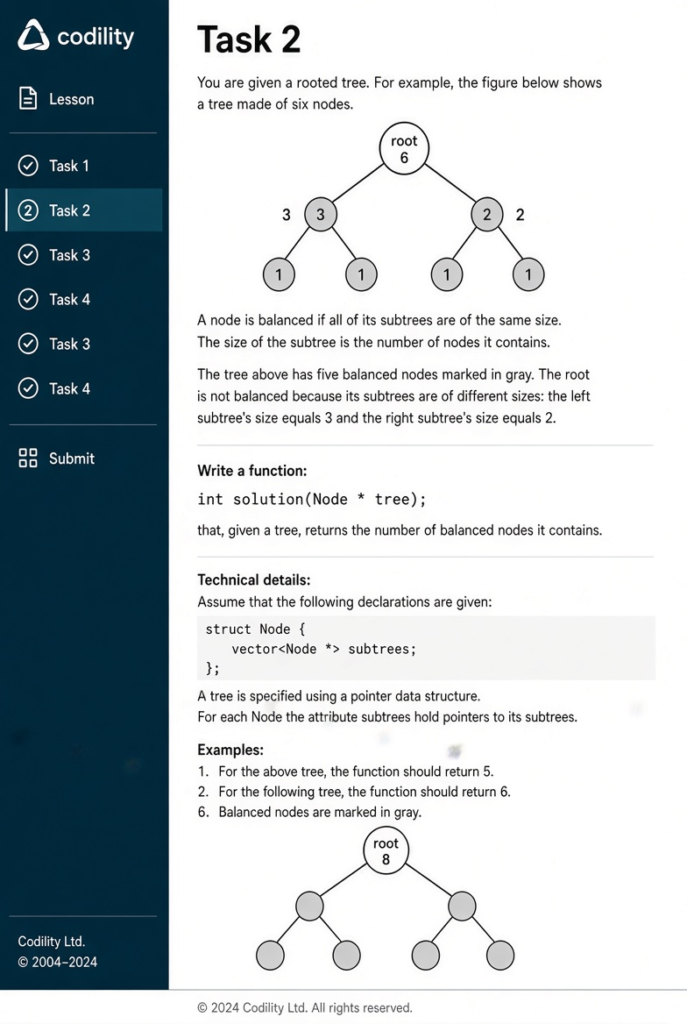
给定一棵有根多叉树。一个节点被称为 balanced,当且仅当它的所有子树大小都相同(子树大小 = 该子树包含的节点数,含自身)。返回整棵树中 balanced 节点的个数。
示例:根节点左右子树大小分别为 3 和 2,不相等,故根不是 balanced;其余 5 个节点是,答案为 5。
节点结构大致为:
cpp
struct Node {
    vector<Node*> subtrees;
};
思路
经典”DFS 返回子树大小,同时统计答案”:对当前节点的所有孩子,先递归得到各子树大小;若没有孩子,或所有孩子子树大小都相等,当前节点 balanced,答案加一;当前子树大小 = 1 + 所有孩子子树大小之和,返回给上层。
def count_balanced(root):
    answer = [0]

    def dfs(node):
        if not node.subtrees:
            answer[0] += 1  # 叶子节点视为 balanced
            return 1

        child_sizes = [dfs(child) for child in node.subtrees]

        if len(set(child_sizes)) == 1:  # 所有子树大小相等
            answer[0] += 1

        return 1 + sum(child_sizes)

    dfs(root)
    return answer[0]
叶子节点没有子树,”所有子树大小都相同”的空条件成立,视为 balanced。判断相等用 set 去重后看长度是否为 1,比逐对比较更简洁。时间 O(N),每个节点访问一次。容易漏的边界:叶子节点要计入答案;根节点也需要判断;只有一个孩子的节点天然满足”所有子树大小相同”,也是 balanced。
DRW 面试完整流程参考
DRW 的招聘流程比很多量化公司更紧凑,从 OA 到 Super Day 通常在 3 到 4 周内走完。
OA:HackerRank 或 Codility 平台,约 2 小时,两到三道题。DRW 的 OA 不出纯模板题,每道题的条件设计都有一定独创性,读题时间不能省。
Phone Screen(约 45 分钟):一道算法题加项目背景聊天。面试官会在你写完代码之后追问复杂度、边界情况和优化方向,节奏比较紧。
Super Day(约半天到一天):多轮背靠背,通常包含:
技术轮(1 到 2 轮)——算法题加系统知识,难度比 OA 高,可能涉及并发或内存管理。
数学/概率轮(1 轮)——期望值、条件概率、骰子题、简单博弈,DRW 作为做市商公司,这轮权重很高。
项目深挖轮(1 轮)——针对简历上的项目连续追问,考察工程深度。
BQ 轮(1 轮)——聊团队协作、技术决策、为什么做量化/高频交易方向。
整体节奏比部分量化公司快,OA 做完一周内通常会有消息,没有消息可以主动跟进。
高频题型总结
DRW Intern Online Assessment 高频方向
字符串贪心(奇偶次数约束、字典序最大)——这次 Task 1 就是,DRW 喜欢在常见贪心题上加一层约束,让你想清楚删什么、保什么。
树形 DP / DFS 回传信息——Task 2 是标准的树形 DFS 模式,DRW 的 OA 里多次出现树相关题,提前练熟。
数学建模——部分场次有概率题或组合计数题,要能快速从文字规则建出数学模型。
技术面高频方向
并发和内存——线程安全、锁的粒度、内存对齐,DRW 的系统软件岗面试里出现频率很高。
数据结构实现——手写优先队列、环形缓冲区、Lock-Free 队列,和 Akuna、Jane Street 风格类似。
数学/概率高频方向
期望值(掷骰子系列、停止规则)、条件概率、马尔可夫链基础、简单博弈论——这轮是 DRW 真正的核心筛人环节。
备考建议
OA 的核心是读题速度和建模能力,不是模板覆盖范围。DRW 的题目条件设计得比较精巧,”偶数次约束 + 字典序最大”这种组合约束,如果习惯直接套模板会在边界上出错。建议每次做完题之后,把”如果条件稍微改一下,答案会怎么变”这个问题想一遍,这种训练对 DRW 的题型很有效。
数学/概率这块不能忽略。DRW 作为做市商公司,概率思维是真实的工作技能,Super Day 的数学轮权重很高,提前把大学概率论的核心概念过一遍,以及 Jane Street、Optiver 的量化面试题练一遍,效果比只刷 LC 更直接。
项目深挖要准备到第三四层追问的深度——遇到什么性能瓶颈、用了什么工具 profiling、如果重来会改什么。DRW 的工程师文化很看重你做过的东西是不是真的做过。
DRW、Akuna、Jane Street 这类做市商公司的 OA 有自己的风格——不是纯 LC 模板,更在意你能不能快速读懂一个定制化的规则然后建模实现。InterviewShow 长期跟进这类公司的题型更新,字符串贪心、树形 DFS、概率数学这几块都有覆盖,备考这类量化公司 OA 的同学可以来看看。
FAQ
What is OA in an interview?
OA 是 Online Assessment 的缩写,指在线测评。企业通常会在正式面试前安排 OA,用于评估候选人的 Coding 能力、Problem-Solving Skills 和技术基础。常见形式包括算法编程题、SQL 题和其他与岗位相关的测试,具体内容取决于公司和职位。
How hard is it to get into DRW?
进入 DRW 的难度较高,尤其是 Quantitative Trading 和 Software Engineering 等岗位。候选人通常需要具备扎实的编程基础、较强的逻辑思维能力和良好的问题解决能力。招聘流程可能包括 OA、技术面试以及其他与岗位相关的评估,具体要求会因职位和招聘级别而有所不同。
What types of questions are asked in the DRW OA?
DRW OA 的题目类型取决于申请的岗位。对于 Software Engineering 岗位,常见考察内容包括 Data Structures、Algorithms 和 Problem-Solving,可能涉及数组、字符串、哈希表、树、图和动态规划等知识点。建议提前练习常见 Coding 题型,并熟悉在线编程平台的答题环境和时间限制。