刚做完 Two Sigma OA,三题都过了。进去之前以为量化公司会出一堆概率数学题,结果三道都是算法实现——但不是 LC 那种,是插值、回归、在线统计更新。如果只刷了 LC 进去会有点懵,因为你会的那些模板完全用不上。
T1:Linear Interpolator
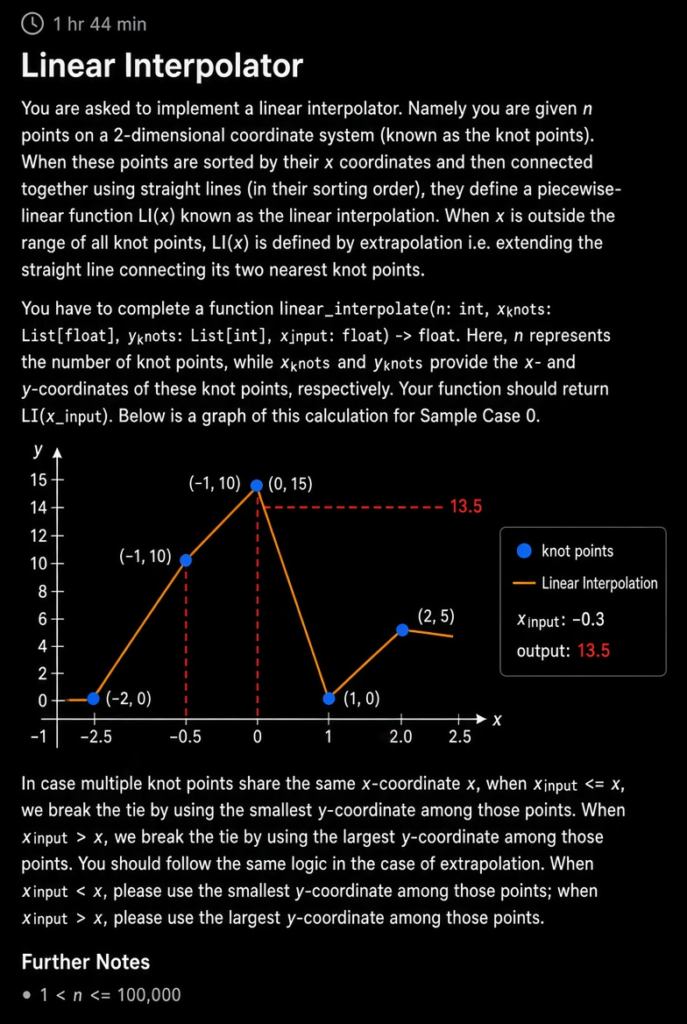
题意
给定 n 个二维坐标点(knot points),按 x 排序后用直线连接,形成分段线性函数。给定查询 x_input,返回对应的函数值。若 x_input 在所有点的范围之外,做外推(沿最近两端点所在直线延伸)。
特殊规则:多个点有相同 x 时——x_input ≤ x 取这些点中最小 y;x_input > x 取这些点中最大 y。外推时同样遵循这个规则。
约束:n 可达 1e5。
思路
第一步:按 x 合并相同横坐标——同一个 x 下同时记录 y 的最小值和最大值,后续根据查询方向决定用哪个。这一步不能省,否则后面的边界处理会乱成一团。
第二步:对合并后的有序点做二分搜索,找到 x_input 左右相邻的节点。
第三步:在区间内按标准线性插值公式计算:
y = y₁ + (y₂ – y₁) × (x – x₁) / (x₂ – x₁)
第四步:x_input 在所有节点范围之外时,沿最近一段做外推,x 和 y 的取值按特殊规则选 min 或 max。
关键是先合并同 x 再做二分,顺序不能反。另外注意分母 x₂ – x₁ 可能为 0,防御性检查不会错。
T2:Daily Temperature By Town
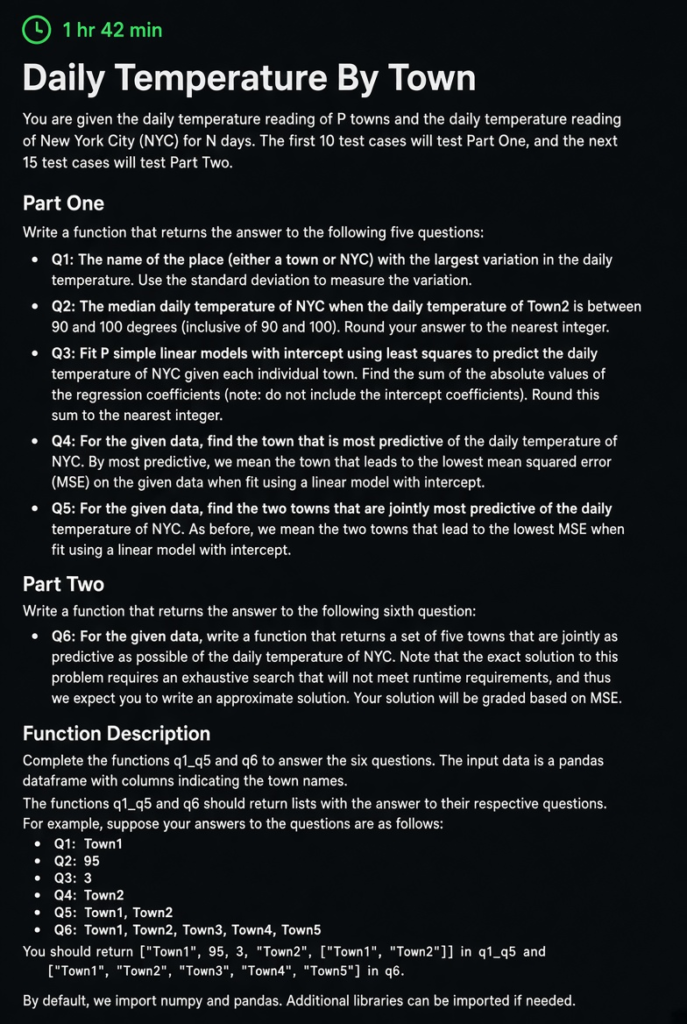
题意
给定 P 个城镇加 NYC 共 N 天的气温数据(pandas DataFrame)。分 Part One 和 Part Two。
Part One 五个问:Q1 日温变化最大的地点(标准差衡量);Q2 Town2 气温在 [90, 100] 时 NYC 日温的中位数(四舍五入);Q3 每个城镇单独拟合带截距的线性模型预测 NYC,对所有回归系数绝对值求和(不含截距)取整;Q4 预测性最强的单个城镇(MSE 最低);Q5 联合预测性最强的两个城镇(MSE 最低)。
Part Two(Q6):返回联合预测性尽量强的五个城镇集合,完整枚举超时,需要近似解,按 MSE 评分。
思路
Q1:对每列算 std,取最大值对应的列名,一行搞定。
Q2:布尔索引筛出 Town2 在 [90, 100] 的行,对 NYC 列取 median 再 round。注意 Python 的 round() 是银行家舍入,题面如果要求标准四舍五入要用 Decimal 或手写。
Q3 到 Q5:sklearn 的 LinearRegression 或手写最小二乘,Q3 对所有系数取绝对值求和(截距不算),Q4 Q5 比较 MSE 取最小。
Q6:贪心近似——每轮从剩余城镇里选一个加入后 MSE 下降最多的,重复五轮。不是全局最优但能过评分,完整枚举 P 选 5 在 P 稍大时直接超时。
数据里可能有 NaN,dropna 之后再做回归;Q3 明确说不含截距,别把 intercept_ 也加进去。
T3:Efficient Regression V5
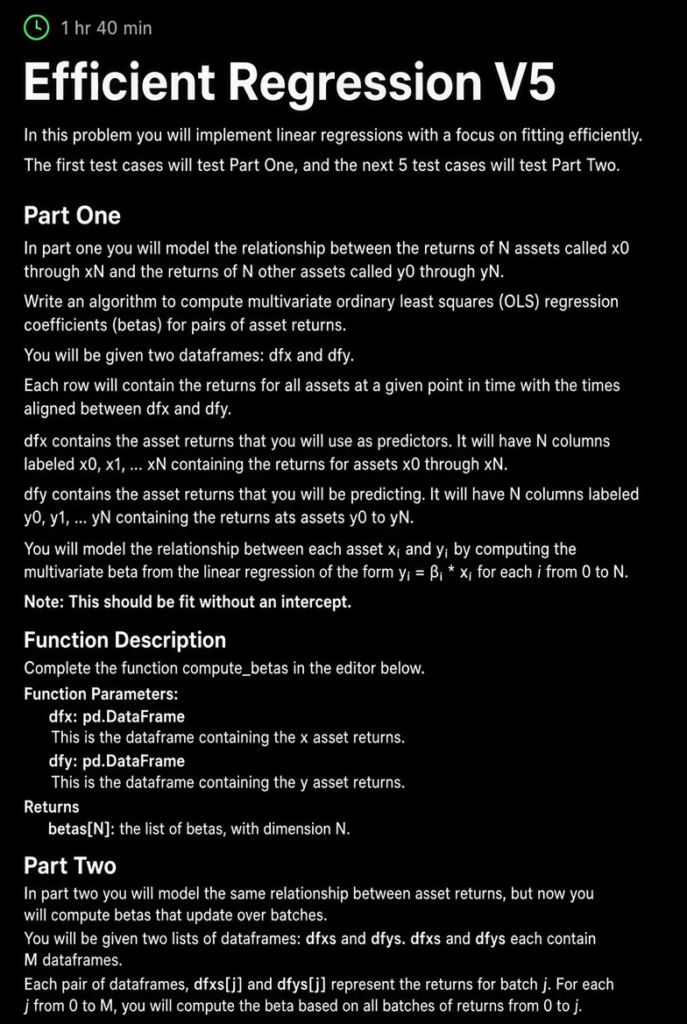
题意
Part One:对多对资产收益做无截距一元 OLS,计算 beta。给定两个对齐的 DataFrame dfx、dfy,对每对 (xi, yi) 拟合 y = β × x(无截距),返回所有 beta。
Part Two:数据按 batch 到达,需要在线/增量更新 beta,不能每次全量重算。
思路
Part One 直接用无截距 OLS 的闭式解:
β = Σ(x × y) / Σ(x²)
对每对列分别算 sum(x × y) 和 sum(x²) 再相除,注意分母为零的情况。
Part Two 的关键洞察是”充分统计量”:无截距 OLS 只需要两个累积值 sum_xy 和 sum_x2。每来一批新数据只做增量累加,不需要存历史数据,不需要重复合并 DataFrame。
想到这一点,Part Two 就只剩几行代码。
备考建议
图论和 BFS 优先级最高。 状态扩展 BFS((x, y, k) 这类三维状态)是 Waymo 特有的变形,单纯的模板不够用,要专门练带状态的版本。
Geometry 看 team。 如果面 perception 或 planning 方向,凸包、多边形相交比图论还高频。dataford.io 指南专门列了这一块,如果是 infrastructure 方向可以优先级放低。
Follow-up 专门练。 每道题写完之后追问自己”如果是流式数据怎么办””如果地图动态变化怎么办””如果内存受限怎么办”,这个习惯比多刷题有用。
C++ 看岗位。 Onboard 和 robotics 相关的岗位,C++ memory management(smart pointers、move semantics)和 concurrency 是真实考点;infrastructure 和 platform 方向 Python 通常够用。
Two Sigma 的 OA 考的是”能不能把数学概念正确实现”,不是”能不能套模板”。T1 的线性插值和 T3 的增量回归在他们的 OA 里反复出现,属于可以提前写熟的模板题;T2 的多问数据分析才是真正考你 pandas 和 sklearn 熟练度的地方,时间分配要多留给 T2。
有在准备 Two Sigma 或其他量化公司 OA 的同学,InterviewShow 长期跟进这类题型,插值、OLS 回归、在线统计量这几块都有覆盖,有需要的来聊。