这次整理了两道 McKinsey OA 真题,考试平台是 HackerRank。一道是数组成本优化,看的是插入一个整数后成本怎么变;另一道是机器学习分类,要先处理数据、挑选特征,再训练模型。这两题都不难看出思路,真正拉开差距的是对题目要求的理解和实现时的细节。
第 1 题:插入一个整数使数组成本最小
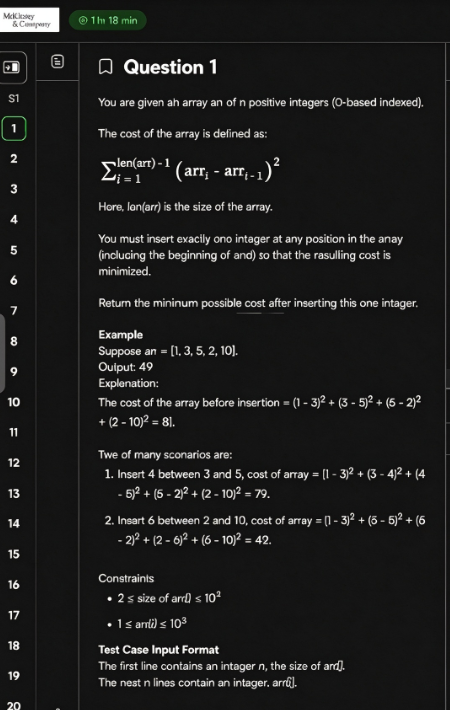
题目描述
给定一个包含 n 个正整数的数组 arr,数组采用从 0 开始的索引。数组的成本(cost)定义为相邻元素之差的平方和:cost(arr) = Σ(i=1 to len(arr)-1) (arr[i] – arr[i-1])² 其中,len(arr) 表示数组的长度。你必须在数组中的任意位置恰好插入一个整数,可以插入到数组的开头或末尾,使插入后的数组成本最小。请返回插入这一个整数后,数组所能达到的最小可能成本。
解题思路
要求插入一个整数,使得 sum( (a[i] - a[i - 1])^2 )尽可能小。我们只需要考虑每一对相邻元素之间插入一个数,计算插入前后的成本变化即可。对于相邻的两个数,显然插入它们的中点能使这部分的平方差之和最小。最后,遍历所有相邻元素,计算插入后的新成本,并与原数组成本进行比较,取最小值作为答案。
第 2 题:基于用户属性的机器人分类预测
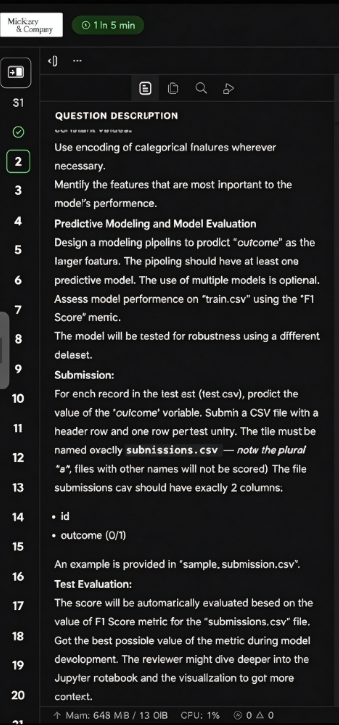
题目描述
根据用户属性判断其是否为机器人。首先进行数据清洗,将 unknown 和不合理的二元值作为缺失值处理;然后筛选相关字段,并剔除部分异常值,最后使用随机森林(Random Forest)模型完成分类预测。
解题思路
题目要求根据用户属性判断其是否为机器人。首先进行数据清洗,将 unknown 和不合理的二元值作为缺失值处理;然后筛选相关特征,并剔除部分异常值,最后使用随机森林(Random Forest)模型进行分类预测。
如何备考 McKinsey OA
准备 McKinsey OA,除了刷题和练数据分析,也别忘了为后面的面试做准备。
- 算法与编程: 多练数组遍历、边界情况和局部优化。像数组成本最小化这类题,先分析一次操作会影响哪些相邻元素,再确定最优方案。
- 数据处理与机器学习: 熟悉缺失值处理、异常值识别、特征筛选和常见分类模型。机器人识别这类任务,要理解随机森林的基本原理,也要知道怎么评估分类效果。
- 模型评估: 掌握 F1 Score 等常用指标,搞清楚 Precision 和 Recall 各自对结果的影响,同时留意模型的泛化能力。
- 个人经历: 提前准备两个真实案例,最好能体现解决问题、团队合作、领导力或克服困难的能力,并把背景、你采取的行动和最终结果理清楚。
- 限时练习与复盘: 按考试时间来练,做完检查代码逻辑、边界情况和模型评估过程。复盘时把容易出错的地方记下来,慢慢提高速度和准确率。
不同岗位的 OA 和面试流程可能不一样,建议结合目标岗位的具体要求来准备。
总结
这两道题看着简单,但都有容易丢分的地方。数组题别急着写代码,先想清楚插入一个数到底改变了哪几项差值,其余部分原封不动,局部算清楚就够了。分类题的重点不在模型本身,随机森林调用起来很快,花时间的是前面的清洗和特征处理,以及最后用测试集上的结果来判断模型好不好。
如果你正在准备 McKinsey 或其他大厂的 OA 或面试,除了刷题,也可以结合真实面经熟悉常见题型和考察方向。InterviewShow 整理了 Microsoft、Amazon、McKinsey、Google、Stripe、TikTok 等科技公司的面试资料,可领取相关公司的 OA/VO 真题,帮助你了解常见考点和面试形式。我们也提供 OA 辅助和面试辅助服务,覆盖 Coding、System Design 和 BQ。你可以查看服务介绍,或直接联系我们了解详情。
McKinsey OA 常见问题(FAQ)
1. McKinsey OA 主要考什么?
具体内容取决于申请的岗位。不同岗位可能涉及编程、数据分析、机器学习或其他能力评估,建议以招聘人员提供的考试说明为准。
2. McKinsey OA 的数组成本题怎么解?
核心是分析插入一个整数后,相邻元素的平方差之和如何变化。遍历相邻元素对,考虑在两者之间插入中点,并比较插入前后的成本,即可找到最优方案。实际实现时还需要注意整数取值和边界情况。
3. 机器人分类题使用什么机器学习模型?
这道题可以使用 Random Forest(随机森林)进行分类。建模前需要处理缺失值、检查不合理的二元值、筛选特征,并根据数据情况处理异常值。最终还要使用适当的分类指标评估模型表现。