近两年校招和 NG 的 Capital One OA 基本都走 CodeSignal,70 分钟四道独立题。风格很稳:前两题多为 Easy 模拟/计数,后两题开始上实现量和数据结构。这场也是这个节奏。有一个值得提前说的观察:CodeSignal 的题库是固定的,Capital One 的 OA 从里面抽题,题型反复复用,抽到完全没见过的概率不高。做熟常见模式比临场现推稳很多。
整体体感
70 分钟四题的时间分配大概是:
- Q1(Easy):8-10 分钟
- Q2(Easy-Medium):12-15 分钟
- Q3(Medium):18-20 分钟
- Q4(Medium-Hard):20-25 分钟
我的实际用时是:Q1 9min、Q2 11min、Q3 17min、Q4 25min,最后剩下 8 分钟检查。Q4 超时的那个 case 是因为我最开始用了嵌套循环,后来想起来用字典优化才改的,但已经提交过一次了。
Q1:Good Tuples(连续三元组)
题意
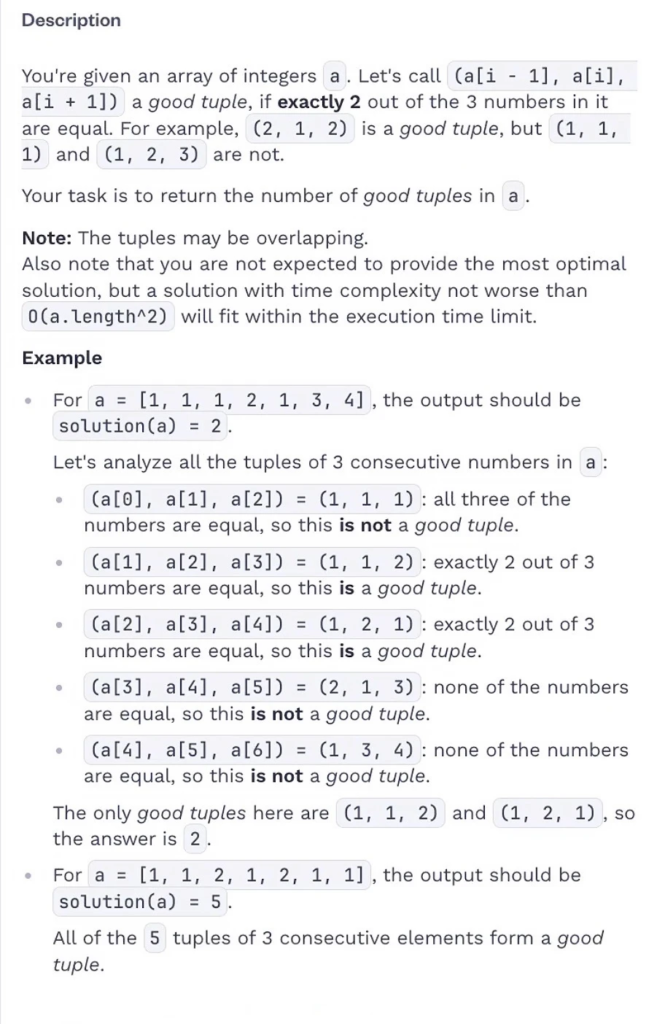
给定数组 a,统计所有连续三元组 (a[i-1], a[i], a[i+1]) 中有多少个是”好三元组”。好三元组的定义是:恰好有两个数相等(不能三个都相等,也不能三个互不相同)。
示例:[1,1,1,2,1,3,4]
(1,1,1):三个全等,不算;(1,1,2):两个相等,算;(1,2,1):两个相等,算;(2,1,3):互不相同,不算;(1,3,4):互不相同,不算。答案 2。
思路
从下标 1 扫到 n-2,统计每个三元组里相等的”对数”:
def goodTuples(a):
    count = 0
    for i in range(1, len(a) - 1):
        equal_pairs = (a[i-1] == a[i]) + (a[i] == a[i+1]) + (a[i-1] == a[i+1])
        if equal_pairs == 1:
            count += 1
    return count
三个比较里恰好一个为 True 就是好三元组。O(n) 一遍过。
容易踩的坑:循环范围是 range(1, len(a)-1),别写成 range(len(a)-2) 然后下标对不上;”恰好两个相等”等价于”恰好一对”,不是两个不同的数值。
Q2:循环移位后的绝对差之和
题意
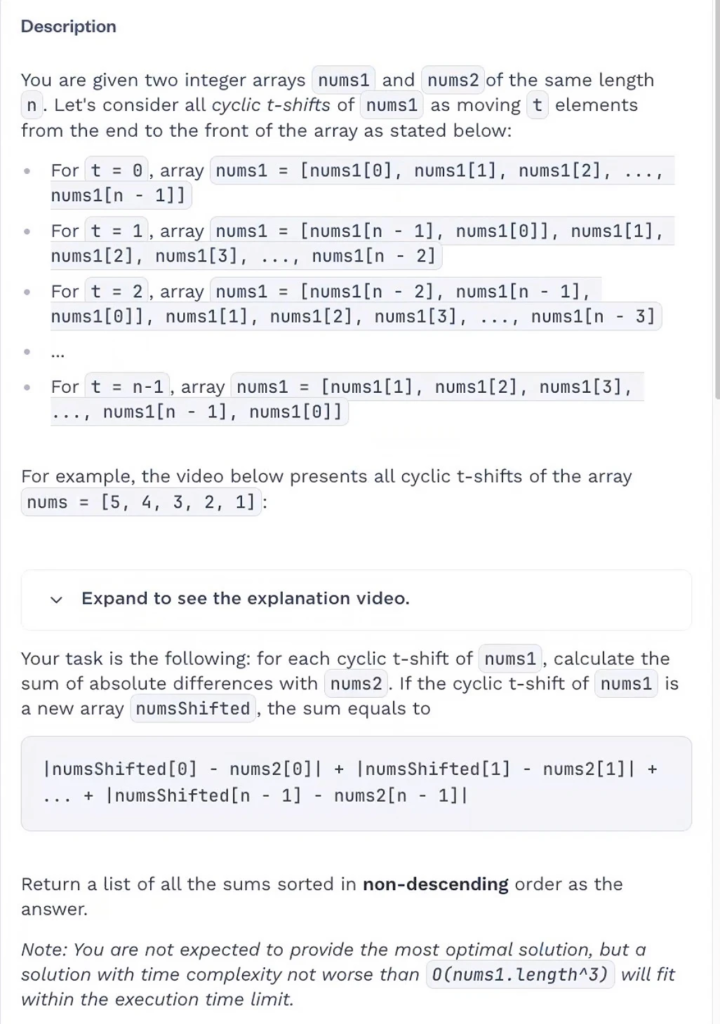
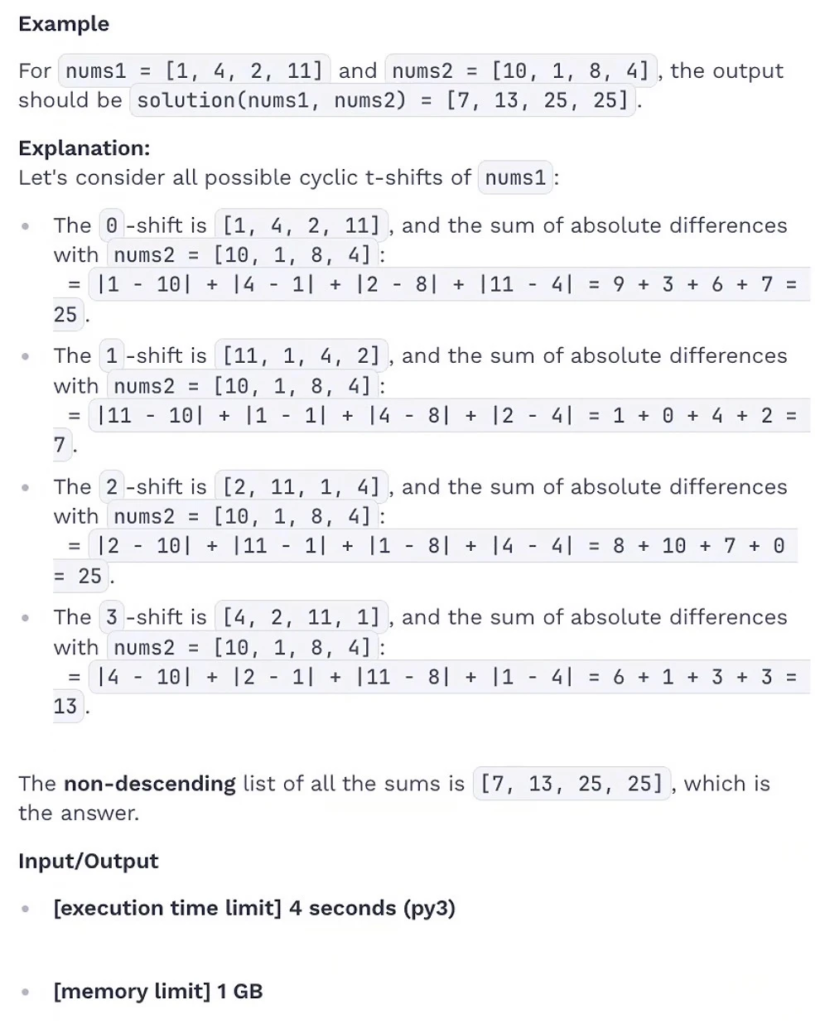
两个等长数组 nums1、nums2。对 nums1 做所有循环右移(t = 0 到 n-1),每次移位后与 nums2 对应位置求绝对差之和,把所有和按非降序排序后返回。
示例:nums1 = [1,4,2,11],nums2 = [10,1,8,4]
右移 0 位:[1,4,2,11] → 9+3+6+7 = 25;右移 1 位:[11,1,4,2] → 1+0+4+2 = 7;右移 2 位:[2,11,1,4] → 8+10+7+0 = 25;右移 3 位:[4,2,11,1] → 6+1+3+3 = 13。
排序后:[7, 13, 25, 25]。
思路
n 不大,直接模拟:
def absoluteDifferenceSum(nums1, nums2):
    n = len(nums1)
    results = []
    for t in range(n):
        total = sum(abs(nums1[(i - t + n) % n] - nums2[i]) for i in range(n))
        results.append(total)
    return sorted(results)
右移 t 位之后,新数组第 i 位对应原数组的第 (i-t+n)%n 位——这个下标方向容易搞反,建议手算一个小例子确认。右移 0 位时 t=0,(i-0+n)%n = i,就是原数组本身,验证一下方向没错。
Q3:带更新的两数之和查询
题意
数组 a、b,以及若干 queries:
[0, i, x]:把 a[i] 赋值为 x;[1, x]:查询有多少对 (i, j) 满足 a[i] + b[j] = x,返回计数。
按顺序处理,返回所有类型 [1] 查询的结果。
示例:a = [3,4],b = [1,2,3]。查询 [1,7]:3+4=7、4+3=7,结果 2;更新 [0,0,5] 后 a = [5,4];查询 [1,8]:5+3=8,结果 1。
思路
b 从头到尾不变,先建 b 的频次表,之后不用再动。
def sumPairs(a, b, queries):
    from collections import Counter
    b_freq = Counter(b)
    results = []
    for query in queries:
        if query[0] == 0:
            a[query[1]] = query[2]
        else:
            target = query[1]
            count = sum(b_freq.get(target - val, 0) for val in a)
            results.append(count)
    return results
三个常见错误:在每次查询时重新计算 b 的频次(完全没必要,b 不变);用 b_freq[key] 而不是 b_freq.get(key, 0)(Counter 默认返回 0,但显式 get 更安全);a 中有重复元素时去重(不能去重,每个 a[i] 都是独立的配对来源)。
Q4:带更新的两数之和查询
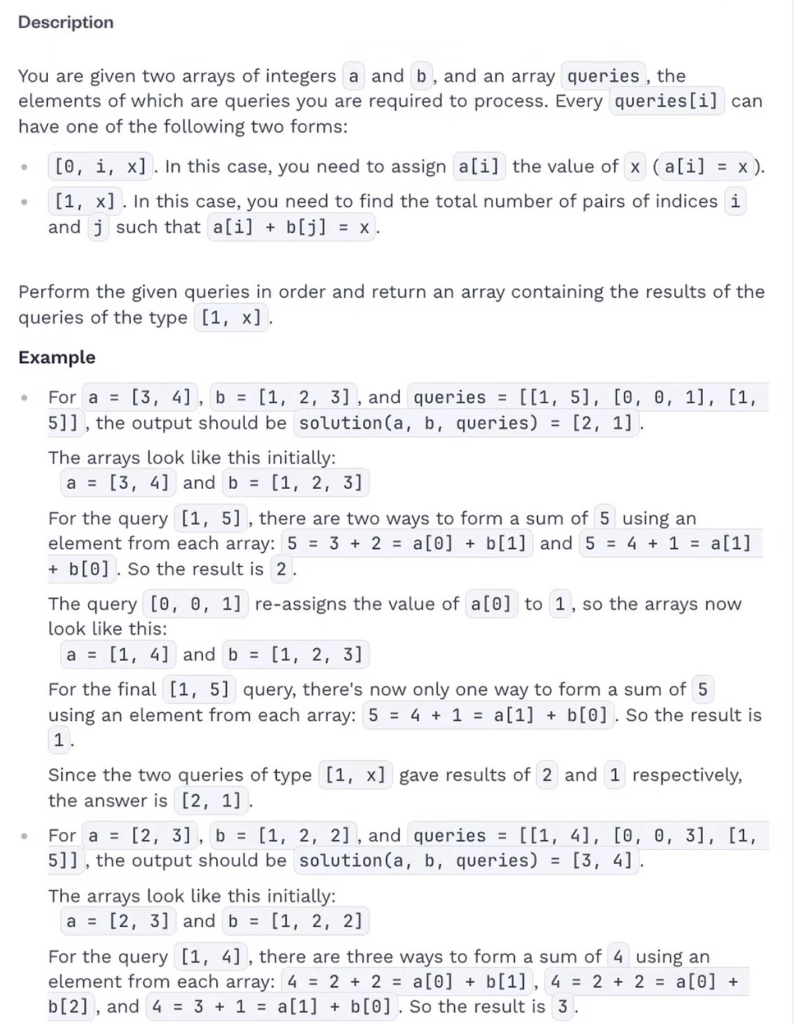
题意
数组 a、b,以及若干 queries,每条是以下两种之一:
[0, i, x]:把 a[i] 赋值为 x;[1, x]:查询有多少对 (i, j) 满足 a[i] + b[j] = x,返回计数。
按顺序处理,返回所有类型 [1] 查询的结果列表。
示例:a = [3,4],b = [1,2,3],queries = [[1,5],[0,0,1],[1,5]]
第一次查询 [1,5]:3+2=5、4+1=5,结果 2;更新 [0,0,1] 后 a = [1,4];第二次查询 [1,5]:1+4 不对、4+1=5,结果 1。输出 [2,1]。
思路
b 从头到尾不会被修改——这是这道题最重要的观察。既然 b 不变,就先建好 b 的频次哈希表,之后每次查询都直接用,不需要重建。
查询 [1, x] 时:遍历当前 a 中每个值 v,在 b 的频次表里查 x-v 出现几次,累加。单次查询 O(|a|),不需要双重循环暴力枚举所有 (i,j) 对。
更新 [0, i, x] 时:直接改 a[i] 就好,b 不变所以频次表完全不用动。
from collections import Counter

def solve(a, b, queries):
    b_freq = Counter(b)
    results = []
    for query in queries:
        if query[0] == 0:
            a[query[1]] = query[2]
        else:
            target = query[1]
            count = sum(b_freq.get(target - v, 0) for v in a)
            results.append(count)
    return results
三个容易写错的地方
第一,b_freq 只建一次,不要在每次查询时重新 Counter(b)——b 不变,重建是纯粹的浪费。
第二,用 b_freq.get(key, 0) 而不是 b_freq[key]——Counter 对不存在的 key 返回 0,但显式 get 更安全,不容易出 KeyError。
第三,a 里有重复元素时不能去重——每个 a[i] 都是独立的配对来源,[3,3] 和 b 里的某个数能配出两对,去重会少算。
Capital One OA FAQ
Capital One OA 和其他 CodeSignal 公司的题库一样吗?
高度重合。Capital One、TikTok、Uber、HRT 都用 CodeSignal 公共题库,刷过一家的题型,其他家进去也会有熟悉感。
四题必须按顺序做吗?
不用,可以先看全部四道题再决定顺序。建议进去先扫一遍,确认哪题最顺手,简单的先拿分。
Q3 如果 a 数组很大,遍历 a 会超时吗?
这场的数据范围没到那个量级,遍历 a 每次查询是 O(|a|) 可以接受。如果数据量更大,可以维护 a 的频次表把查询降到 O(1),但这场不需要。
Q4 用暴力能过几个 case?
数据小的 case 能过,数据大的会超时——这场我就是这样,前几个 case 过了后面超时,已经交了一次再改。建议一开始就用差分数组,不要赌数据范围。
Capital One OA 通过之后流程是什么?
通常是 recruiter 电话,然后安排 Power Day——四轮集中在同一天打完,含 BQ、Coding、Case Study 和 System Design。
这套题库稳定吗,还是每场都不一样?
题型方向很稳定,具体题目会换皮,但模拟计数、哈希两数之和、差分数组这几个方向反复出现,练熟这几类模式进去命中率很高。
有在准备 Capital One 或其他 CodeSignal 公司 OA 的同学,InterviewShow 整理了这套题库的高频题型,按目标公司给针对性刷题清单,有需要的来聊。